Október 13.: a Google szerint a PDF-menüd is bekerülhet az AI-összefoglalóba
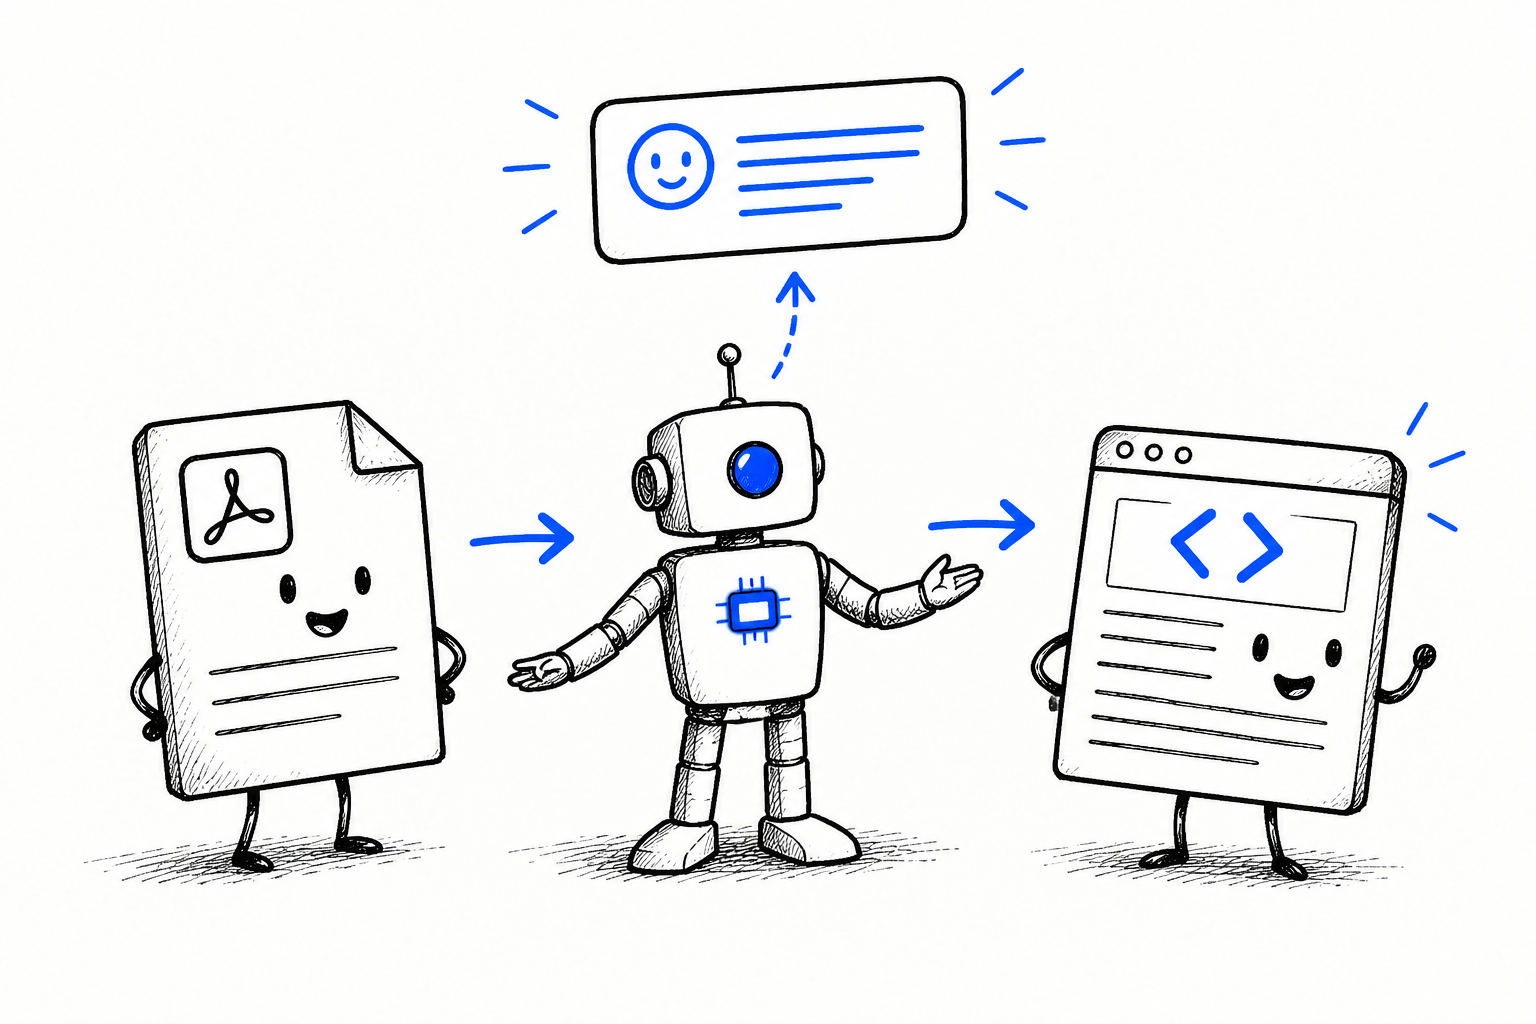
A Google keresési csapata 2026. október 13-án kiadott egy podcastepizódot a PDF-ekről, és két állítás is elhangzik benne, amely a magyar vállalkozóknak közvetlenül szól. Az egyik: a Google az indexeléskor HTML-lé alakítja a PDF-et, onnantól ugyanúgy kezeli, mint bármelyik oldalt, és így az AI-összefoglalóban és az AI Mode-ban is megjelenhet. A másik: egy PDF-ként feltöltött étlap jobb, mintha egyáltalán nem lenne étlap a weboldalon. Átolvastam a teljes átiratot, és összeszedtem, mit állít a Google a PDF-ekről, és mit nem.
Mit mondott a Google október 13-án a PDF-ekről?
A Search Off the Record a Google keresési kapcsolattartó csapatának saját podcastja; itt a 115. epizódról van szó. A beszélgetés Martin Splitt és John Mueller között zajlik, és a teljes átirat PDF-ben is elérhető.
Az indexelésről Splitt ezt mondja 01:56-nál:
What we are doing in Search is we have a component called a converter.
Majd ugyanott:
So we are taking that and producing an HTML version of it so that the processing in the rest of the pipeline pretty much only works with HTML.
Vagyis a Google nem PDF-ként dolgozza fel a fájlt. Csinál belőle egy HTML-változatot, és onnantól a rendszer többi része ezzel dolgozik. Splitt 09:38-nál le is vonja a következtetést:
Yeah, indexing and ranking is pretty much the same as any other document.
Mueller 09:43-nál teszi hozzá azt a mondatot, amiért érdemes volt elolvasni az egészet:
So they can also appear in AI overviews, AI mode, all of those things.
Splitt 09:51-nél így válaszol: „Because it is basically internally a normal HTML page, nothing wild.”
Hogyan kerül a PDF az AI-összefoglalóba?
Az út a podcast szerint közvetett, és a Google dokumentációjából pontosan összeáll.
Először is: a PDF indexelhető fájltípus. A Google indexelhető fájltípusokat felsoroló oldalán ott van az „Adobe Portable Document Format (.pdf)” sor.
Másodszor: az AI-felületeken való megjelenéshez nem kell külön beállítás. A Google AI-funkciókról szóló oldala így fogalmaz:
To be eligible to be shown as a supporting link in AI Overviews or AI Mode, a page must be indexed and eligible to be shown in Google Search with a snippet, fulfilling the Search technical requirements. There are no additional technical requirements.
Tehát ha az oldalad megjelenhet a Google Keresőben kivonattal, akkor az AI-összefoglalóban forráshivatkozásként is megjelenhet. A podcast mondata és ez a dokumentációs sor egy irányba mutat: ha a Google a PDF-et HTML-oldalként dolgozza fel, akkor az AI-felületeken ugyanúgy megjelenhet, mint egy hagyományos aloldal.
Magyarországot illetően egy dolgot tudok biztosan: a Google saját elérhetőségi listája szerint az AI Mode Magyarországon és magyar nyelven is elérhető. A podcastban egyetlen ország sincs megnevezve.
Mit nem mondott a Google?
Négy dolgot érdemes különválasztani, mert az iparági összefoglalók ezeket hajlamosak elhagyni.
Ez podcast, nem dokumentáció. Két Google-alkalmazott beszélget egy mikrofon előtt. Hasznos, hiteles, de nem ugyanaz a műfaj, mint egy frissített fejlesztői oldal, és nem is hivatkozhatsz rá úgy, hogy „a Google dokumentációja szerint”.
Csak a Google rendszereiről beszélt. Splitt 23:49-nél ezt mondja: „And good SEO is good GEO. So a PDF that works for your website works for AI systems as well. At least on ours.” Az utolsó három szó a lényegi megszorítás.
A többi AI-asszisztensről csak feltételezés hangzott el. Mueller 23:00-nál így fogalmaz: „I have seen them also referenced in other AI systems. I assume that most of the AI systems want to be able to train on all of this content, so they want to use PDFs. And they probably also similarly use it for grounding.” Az „I assume” és a „probably” Mueller saját szavai. Ebből nem következik, hogy a ChatGPT vagy a Gemini olvassa a PDF-edet, és én sem mondom, hogy olvassa.
A PDF-ek méretkorlátját a műsorban nem tudták megmondani. Splitt 06:04-nél ezt mondja: „But I don't know the specific limit for PDF files.” A Googlebot dokumentációja viszont leírja: „When crawling for Google Search, Googlebot crawls the first 2MB of a supported file type, and the first 64MB of a PDF file.” A méretkorlát tehát nyilvános, a beszélgetésben viszont nem tudták megmondani.
Étlap és árlista: mikor elég a PDF?
Ez a rész szól a legtöbb magyar vállalkozásnak, mert az étlap és az árlista nálunk tényleg gyakran PDF.
Splitt 08:39-nél ezt mondja:
Restaurants oftentimes have the printers create the menus that they actually physically print on paper as a PDF as well, and you can just upload that to your website. It's better than not having your menu on the website at all.
Mueller 21:43-nál pontosít, és itt hangzik el a teljes válasz:
If the option is have a menu as a PDF or don't have a menu at all, then yes, I would prefer to have a menu. But if the option is menu as a PDF versus a normal web page, I kind of like normal web pages because it's easier to interact with them.
Kétféle helyzetet választ szét, és a válasz attól függ, melyikben vagy. PDF a semmi helyett: a PDF jobb. PDF a weboldal helyett: a weboldal jobb. Mueller ugyanitt hozzáteszi, hogy „It's not that from an SEO point of view it's impossible.”
Splitt 13:17-nél egy gyakorlati érvet is említ a HTML-oldal mellett: mobilon a PDF-nek előbb teljesen le kell töltődnie, és csak utána látszik, míg a HTML azonnal elkezd megjelenni.
Hogyan pontosítom a szeptember 17-i tanácsomat?
A tanácsomat nem vonom vissza, de pontosítanom kell: a két állítás ugyanarra a fájltípusra vonatkozik, és mégis két különböző kérdést válaszol meg.
Az országos mérésben azt írtam: „Ne PDF, ne kép, ne külön táblázat.” Ez arról szólt, hogy az AI tudja-e idézni az árat a hozzá tartozó szolgáltatás nevével együtt. Abban a mérésben az számított hibának, ha az ár letölthető PDF-ben, képen vagy olyan táblázatban volt, amelyben a szolgáltatás neve és az ára nincs egymáshoz rendelve.
A Google október 13-i állítása arról szól, hogy a saját feldolgozólánca egyáltalán el tudja-e olvasni a fájlt. A kettő nem ugyanaz a kérdés, és mindkettő igaz lehet egyszerre: a Google beolvashatja a PDF-be írt árlistádat, de ha a fájlban az ár nincs a szolgáltatás nevéhez kötve, az AI akkor sem tudja a kettőt együtt idézni.
A szeptemberi tanácsomat tehát így pontosítanám: ha az ár vagy az étlap fontos neked, HTML-oldalon legyen, mert ott az árat a szolgáltatás vagy az étel neve mellé tudod írni, és a látogatónak nem kell letöltenie semmit. Ha most csak PDF van, akkor ne vedd le. Tedd ki mellé a HTML-változatot, amikor tudod. A válasszal kezdődő szerkezetről külön írtam, és az ott leírt felépítés pont ezt a problémát oldja meg.
Hat teendő, ha PDF van a weboldaladon
Mindegyik a podcastban elhangzott konkrét állításon vagy a Google dokumentációján alapul.
Először nézd meg, hogy szöveg van-e benne. Nyisd meg a PDF-et, és próbáld kijelölni az árat vagy az étel nevét. Splitt 11:32-nél így írja le ugyanezt a próbát: „If text shows up, congratulations, it's not lost in the rasterized page. If it's not there, then that is a problem. Then we can't see the content inside the PDF.” Ha nem tudod kijelölni, akkor a PDF valószínűleg csak képet tartalmaz, és a benne lévő árat a Google nem látja.
Másodszor linkelj vissza a weboldaladra a PDF tetejéről. Mueller 15:06-nál ezt mondja: „Another thing that I've seen mentioned, which I think makes a lot of sense, is just to make sure that you link to your actual site from the top of your PDF somewhere.” Ha valaki a PDF-et találja meg, egy kattintással eljuthasson onnan a honlapodig.
Harmadszor, ha ugyanaz a tartalom HTML-ben és PDF-ben is megvan, állítsd be a canonical fejlécet. Mueller ugyanitt megjegyzi, hogy ezt kevesen teszik meg, mert körülményes. A Google duplikált URL-ekről szóló oldala így írja: „If you publish content in many file formats, such as PDF or Microsoft Word, each on their own URL, you can return a rel="canonical" HTTP header to tell Googlebot what is the canonical URL for the non-HTML files.” Ugyanez az oldal hozzáteszi, hogy ezt a módszert a Google csak a webes keresési találatokra támogatja.
Negyedszer adj új fájlnevet, amikor frissítesz. Mueller 17:23-nál elmondja, miért: „So our systems are not going to refetch the PDF file every couple of minutes, because they basically assume that this file is probably not going to change for a really long time.” Majd: „That also means that if you do want to make changes to a PDF file, it can make sense to just use a new file name.” Ha tehát az áraid januárban változnak, az arlista-2027.pdf hamarabb bekerülhet a Google indexébe, mint a felülírt arlista.pdf.
Ötödször ne tedd indexelhetővé az automatikusan generált, nyomtatható PDF-másolatokat. Mueller 18:59-nél ezt mondja: „So anything where you have fresh and dynamic content, I would generally avoid making that indexable if you need to use a PDF.”
Hatodszor, ha egy PDF-et ki akarsz venni a keresésből, az X-Robots-Tag válaszfejléc a módszer. A Google robots meta tagekről szóló dokumentációja kimondja: „To block indexing of non-HTML resources, such as PDF files, video files, or image files, use the X-Robots-Tag response header instead.” A HTML-oldalakon használt meta robots címke a PDF-ben nem működik. A három kapcsolóról szóló írásban végigvettem, melyik beállítás mit vesz ki az AI-összefoglalóból.
És az llms.txt?
Erről is szó esett, két mondatban. Splitt 01:08-nál annyit mond: „Just no. No, don't.” Mueller 24:02-nél zárja le a témát: „And no LLMs.txt in PDFs, please.”
Ez összhangban van azzal, amit a magyar oldalak llms.txt-fájljairól mértem. A Google Keresője nem használja ezt a fájlt, és most már azt is tudjuk, hogy a Google szerint PDF-be se tedd bele.
Amit nem tudok
Nem futtattam tesztet arra, hogy a magyar AI-összefoglalókban megjelenik-e magyar PDF forrásként. A podcast azt mondja el, hogy a PDF is megjelenhet az AI-összefoglalóban, nem azt, hogy a gyakorlatban mit választ ki a rendszer.
Nem tudom, a többi AI-asszisztens olvassa-e a PDF-eket. Erről csak Mueller feltételezése hangzott el, és azt fentebb szó szerint idéztem.
És nem tudom, miért nem jutott eszükbe a 64 MB-os korlát, amikor a Google saját oldala leírja. Egy beszélgetésben ez előfordul; nem hiba.
Az átiratot és a hat Google-oldalt 2026. október 14-én nyitottam meg, és a fenti angol mondatokat onnan idézem szó szerint. A fordítások és a következtetések a sajátjaim.
Gyakori kérdések
Megjelenhet a PDF-em a Google AI-összefoglalójában és az AI Mode-ban?
A Google keresési csapata 2026. október 13-án ezt mondta a saját podcastjában: „So they can also appear in AI overviews, AI mode, all of those things.” Az indoklás az, hogy a Google indexeléskor HTML-változatot készít a PDF-ből, és onnantól a feldolgozólánc többi része csak HTML-lel dolgozik, tehát a PDF ugyanúgy indexelődik és rangsorolódik, mint bármelyik más dokumentum. A Google AI-funkciókról szóló dokumentációja hozzáteszi, hogy az AI-összefoglalóban vagy az AI Mode-ban való megjelenéshez nincs semmilyen további műszaki követelmény azon túl, hogy az oldal indexelt legyen és megjelenhessen kivonattal a Google Keresőben. Egy megszorítás van: a Google a saját rendszeréről beszélt, a többi AI-asszisztensről nem.
Elég, ha az étlapom csak PDF-ben van a weboldalamon?
A Google két helyzetet választ szét, és a válasz attól függ, melyikben vagy. Ha az a két lehetőség, hogy az étlap csak PDF-ben érhető el, vagy egyáltalán nincs étlap, akkor a PDF jobb: Martin Splitt szerint „It's better than not having your menu on the website at all.” Ha a választás az, hogy PDF vagy rendes weboldal, akkor John Mueller a weboldalt választja, mert azt könnyebb használni. Ugyanő hozzáteszi: „It's not that from an SEO point of view it's impossible.” Egy mobilos érv is elhangzott: a PDF-nek előbb teljesen le kell töltődnie, és csak utána jelenik meg, míg a HTML azonnal elkezd megjelenni. Ha az ár fontos neked, HTML-oldalra tedd, mert ott kötöd össze a szolgáltatás nevét a számmal.
Hogyan ellenőrizhetem, hogy a Google el tudja olvasni a PDF-em szövegét?
Nyisd meg a fájlt, és próbáld kijelölni benne az árat vagy a termék nevét. Martin Splitt ugyanezt a próbát javasolja: „If text shows up, congratulations, it's not lost in the rasterized page. If it's not there, then that is a problem. Then we can't see the content inside the PDF.” Ha nem tudod kijelölni a szöveget, akkor a PDF valójában kép, és a benne lévő szöveget a Google nem látja. Ez a leggyakoribb eset a nyomdától kapott étlapoknál és árlistáknál, mert azokat nyomtatásra készítették.
Olvassák a PDF-eket a ChatGPT-hez hasonló AI-asszisztensek is?
Erre nincs bizonyíték, és a Google sem állította. John Mueller ezt mondta: „I have seen them also referenced in other AI systems. I assume that most of the AI systems want to be able to train on all of this content, so they want to use PDFs. And they probably also similarly use it for grounding.” Az „I assume” és a „probably” a saját megfogalmazása. Martin Splitt pedig a Google rendszerére szűkítette az egészet: „a PDF that works for your website works for AI systems as well. At least on ours.” Amíg nincs mérés, a HTML-oldal a biztosabb választás, ha azt szeretnéd, hogy több AI-asszisztens is megtalálja az adatot.
Mekkora PDF-et olvas végig a Google?
A Googlebot-dokumentáció szerint 64 MB-ot: „When crawling for Google Search, Googlebot crawls the first 2MB of a supported file type, and the first 64MB of a PDF file.” Érdekesség, hogy a 2026. október 13-i podcastban ez a szám nem hangzott el, Martin Splitt ott azt mondta: „But I don't know the specific limit for PDF files.” A korlátot tehát közzétette a Google, a beszélgetésben viszont nem tudták megmondani. Egy étlap vagy egy árlista jóval a korlát alatt van, úgyhogy a gyakorlatban ez a kérdés ritkán jelent problémát.
Hogyan frissítsem az árlista-PDF-et, hogy a Google hamar észrevegye?
Adj neki új fájlnevet. John Mueller elmondta, miért: „So our systems are not going to refetch the PDF file every couple of minutes, because they basically assume that this file is probably not going to change for a really long time.” Majd hozzátette: „That also means that if you do want to make changes to a PDF file, it can make sense to just use a new file name.” Vagyis ha januárban változnak az áraid, a Google hamarabb észreveheti az új nevű PDF-et, mint a felülírt régi fájlt. Ha pedig ugyanaz a tartalom HTML-ben és PDF-ben is megvan, a canonical válaszfejléccel jelezheted, melyik az elsődleges cím.
Hogyan kérhetem, hogy a Google ne indexelje a PDF-emet?
Az X-Robots-Tag válaszfejléccel. A Google robots meta tag oldala kimondja: „To block indexing of non-HTML resources, such as PDF files, video files, or image files, use the X-Robots-Tag response header instead.” A HTML-oldalakon megszokott meta robots címkét a PDF-be nem tudod beírni, tehát ott ez a módszer nem működik. Érdemes külön elgondolkodni az automatikusan generált, nyomtatható PDF-másolatokon: Mueller szerint a friss és dinamikus tartalomnál általában kerülné, hogy ezek indexelhetőek legyenek.
Betehetem az llms.txt tartalmát PDF-be?
A Google szerint ne. A 2026. október 13-i epizódban Martin Splitt ennyit mondott a témáról: „Just no. No, don't.” John Mueller pedig így zárta le a témát: „And no LLMs.txt in PDFs, please.” Ez összhangban van azzal, amit a Google máshol is leír: a Google Keresője nem használja az llms.txt-t, és a fájl fenntartása nem javítja, de nem is rontja a helyezésedet.
Források
- Google Search Off the Record, 115. epizód: PDFs in Search, Indexing, AI & Pitfalls (2026. október 13.)
- Az epizód teljes átirata PDF-ben
- Google Search Central: AI-funkciók és a weboldalad (a megjelenés feltételei)
- Google Search Central: Googlebot (a 64 MB-os PDF-korlát)
- Google Search Central: indexelhető fájltípusok
- Google Search Central: duplikált címek összevonása (canonical válaszfejléc nem HTML-fájlokhoz)
- Google Search Central: robots meta tag és X-Robots-Tag
- Google Súgó: az AI Mode elérhető országai és nyelvei (Magyarország és a magyar nyelv szerepel a listán)
- MI-Térkép: országos mérés arról, mit lát az AI a magyar kkv-webből
- MI-Térkép: három kapcsoló, melyik vesz ki az AI-összefoglalóból
- MI-Térkép: ki írta az llms.txt-edet, 219 magyar oldal